让模型服务,
稳定地跑在企业边界内
面向部门级知识助手、业务系统和多用户并发,把 GPU、模型网关、容器平台与运行监控组装成一套可运营的服务节点。
SERVER / MULTI-GPU SERVICE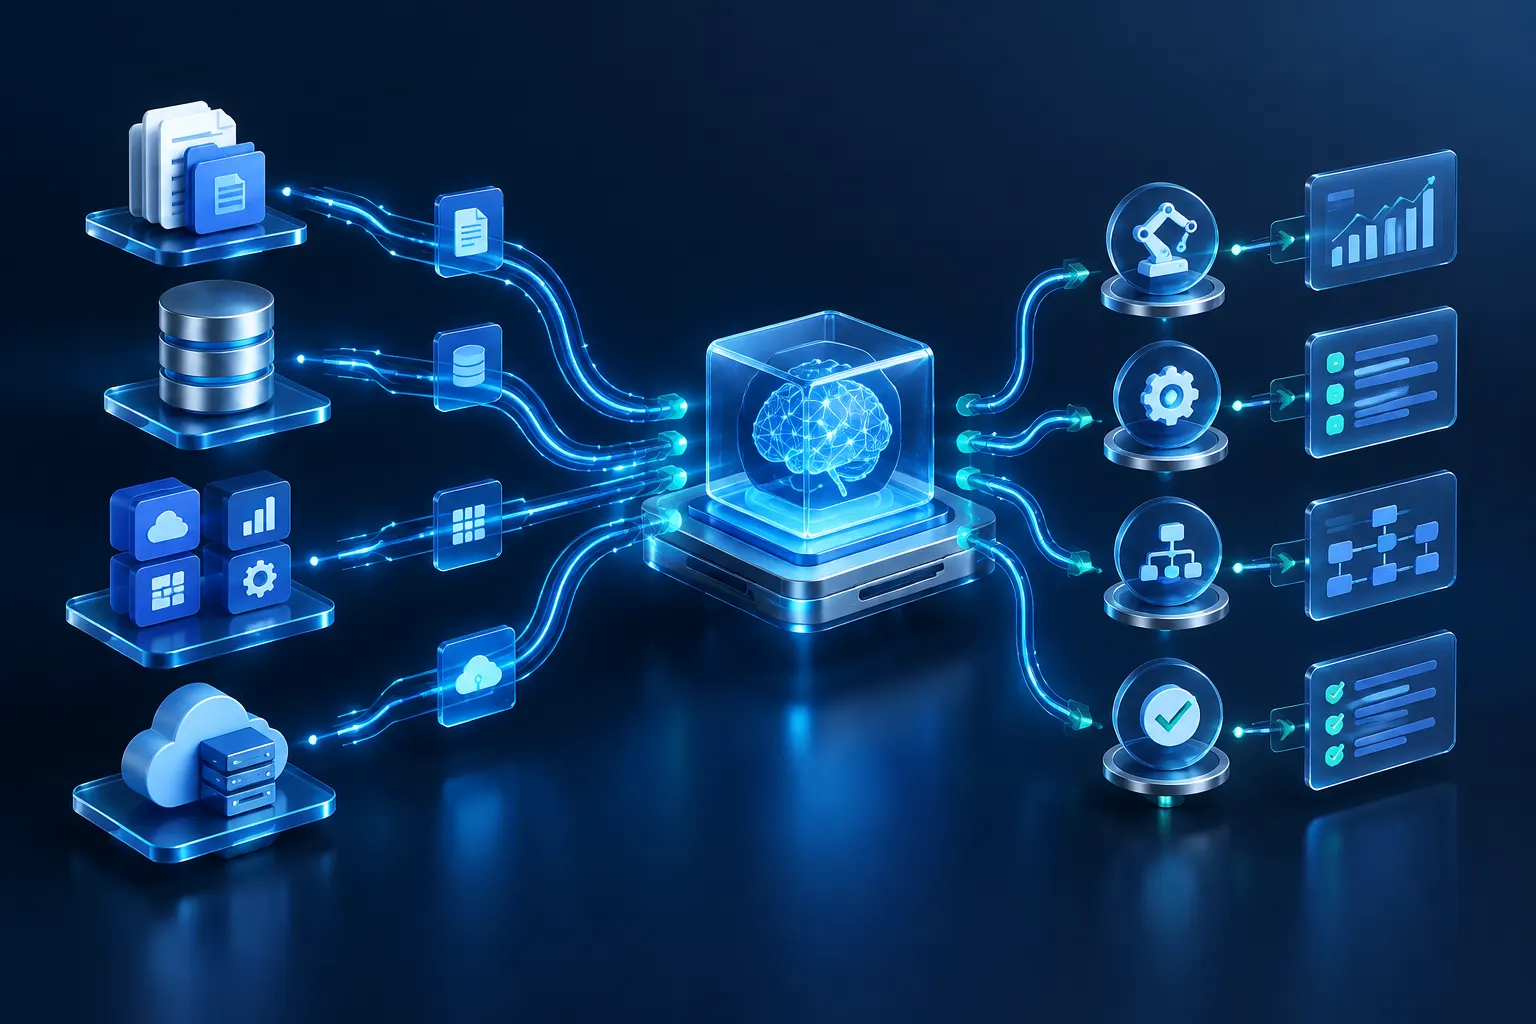
WHY A SERVER01 / 多 GPU 02 / 平台化 03 / 运营化 04 / 参考产品
把一次试点,变成可持续的内部服务
当用户、请求量和数据边界开始稳定,服务器提供更清晰的资源隔离与运维入口。易星云负责从设备选型到模型服务上线的整段交付。
为并发和显存留出余量
依据模型尺寸、上下文长度、并发请求与响应目标规划 GPU 数量、显存、CPU、网络和存储。
一次接入,多模型路由
通过容器化服务、统一 API、模型路由、配额与日志,让业务系统不用重复适配每一类模型。
看得到,也管得住
建立用量、延迟、错误率和资源利用率看板,支持告警、限流、审计与容量复盘。
RTX PRO Server Edition
NVIDIA RTX PRO 6000 Blackwell Server Edition面向多 GPU 服务器部署,覆盖推理、微调、渲染与 HPC。
查看官方产品 ↗让你的模型服务先稳定起来
从模型、并发、数据安全与预算出发,获取一份可交付的服务器架构建议。